Un modello di tennis dipende da come separi i dati nel tempo
Una guida pratica alla validazione temporale, alla separazione per partita e al data leakage nei modelli di tennis.
Per valutare un modello che farà previsioni sulle partite future, addestralo con informazioni precedenti e verificalo su partite successive. Mantieni tutti i punti della stessa partita nella stessa partizione. La separazione cronologica è un punto di partenza: da sola non dimostra che ogni variabile fosse disponibile al momento della previsione.
Definisci il momento della previsione
Prima di scegliere un modello, stabilisci cosa deve prevedere e quando. Un modello pre-partita e uno valutato dopo ogni punto hanno confini informativi diversi.
In un esempio pre-partita, il risultato finale è l'etichetta. Le statistiche dei giocatori sono variabili ammissibili solo se costruibili con informazioni disponibili prima della previsione. Le statistiche finali dell'incontro non diventano variabili pre-partita solo perché compaiono nello stesso archivio storico.
Lo stesso vale per il preprocessing. Adatta imputazione, scaling e selezione delle variabili soltanto sui dati di addestramento, poi applica le trasformazioni alle partizioni successive. La guida di scikit-learn al data leakage spiega perché adattarle su tutto il dataset contamina la valutazione.
Separa nel tempo e mantieni le partite complete
Per valutare le prestazioni future, riserva un periodo successivo alla validazione e uno ancora più recente al test finale. Non scegliere i parametri del modello in base ai risultati di quel test.
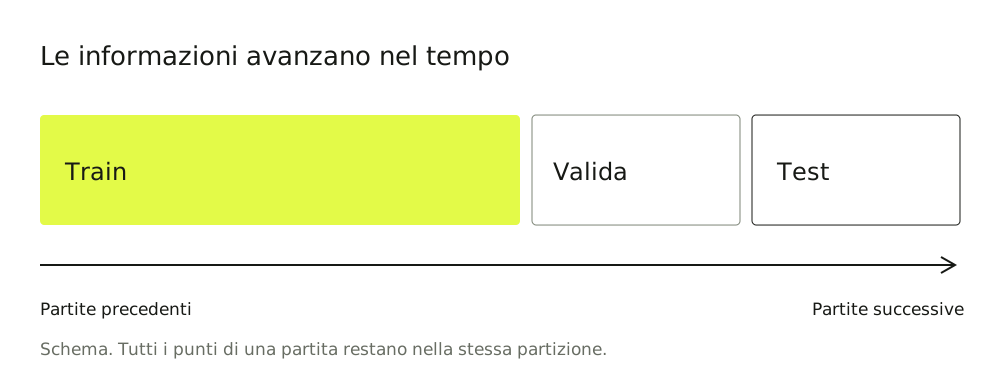
Se il dataset contiene righe per punto, dividi prima la tabella delle partite e associa poi la partizione a ciascun punto. L'assegnazione casuale dei punti può inserire parti della stessa partita sia nell'addestramento sia nel test.
Per incontri sovrapposti, usa un confine conservativo: le etichette di addestramento devono essere note prima della prima previsione della partizione successiva. La sola data di inizio non basta se l'incontro continua oltre il cutoff.
Un punteggio migliore può rispondere alla domanda sbagliata
Prima di confrontare due valori di accuratezza, esamina separazione, campione e variabili disponibili. Un punteggio alto ottenuto con una separazione inadeguata può misurare un compito diverso dalla previsione delle partite future.
Dati illustrativi
Stessa metrica, domande diverse
% accuratezza
| Punti casuali | 84 % accuratezza |
|---|---|
| Partite cronologiche | 68 % accuratezza |
Il grafico non dimostra che la valutazione cronologica riduca sempre l'accuratezza. La domanda utile è se l'esperimento rappresenta le condizioni d'uso previste.
Rendi la valutazione riproducibile
Registra momento della previsione, confini temporali, regole di disponibilità ed esclusioni. La specifica seguente è illustrativa: non è una richiesta API né un contratto pubblicato del dataset.
task: pre_match_outcome
partition_unit: match
ordering: prediction_time
training_labels_known_before: validation_start
preprocessing_fit_on: training_only
final_test_used_for_tuning: false
feature_availability: checked_at_prediction_time
| Controllo | Cosa registrare |
|---|---|
| Campione | Numero di partite, periodo ed esclusioni |
| Variabili | Definizione e disponibilità al momento della previsione |
| Baseline | Un metodo più semplice valutato sullo stesso campione |
| Metriche | Definizioni, denominatori e incertezza |
| Versione | Dati, codice delle variabili e configurazione del modello |
Usa più finestre temporali quando il campione lo permette. La documentazione di scikit-learn descrive la valutazione ordinata nel tempo. I punti di tennis richiedono anche il raggruppamento per partita: uno splitter applicato direttamente alle righe non sostituisce questo confine.
Cosa non dimostra questa valutazione
Una separazione accurata non prova copertura completa, input live affidabili o timestamp storici corretti di disponibilità. Servono evidenze separate. I dati corretti retrospettivamente possono differire da quelli osservabili all'epoca.
Calibrazione delle probabilità e accuratezza di classificazione rispondono a domande diverse. Scegli metriche adatte al compito, definiscile e confronta i metodi sullo stesso campione ammissibile.
Mantieni le evidenze accanto al risultato
Pubblica il contesto necessario per capire l'esperimento. Collega le fonti, spiega i dati mancanti e segnala gli esempi sintetici dove compaiono. Quando cambia un'ipotesi, aggiorna l'articolo e la data di modifica.
Consulta la pagina di copertura e la documentazione API per i limiti del prodotto e l'integrazione.
Fonti
- scikit-learn: data leakage e pratiche consigliate
- scikit-learn: validazione incrociata delle serie temporali
Fonti consultate il 4 ottobre 2026. Il raggruppamento specifico per partita applica questi principi; non è un esperimento misurato.