Um modelo de tênis depende de como você separa os dados no tempo
Um guia prático de validação temporal, separação por partida e vazamento de dados em modelos de tênis.
Para avaliar um modelo que fará previsões sobre partidas futuras, treine com informações anteriores e teste em partidas posteriores. Mantenha todos os pontos de uma mesma partida na mesma partição. A separação cronológica é um ponto de partida; sozinha, não prova que cada variável estava disponível no momento da previsão.
Defina o momento da previsão
Antes de escolher um modelo, defina o que ele deve prever e quando. Um modelo pré-jogo e outro avaliado após cada ponto concluído têm limites de informação diferentes.
Em um exemplo pré-jogo, o resultado final é o rótulo. As estatísticas dos jogadores só são entradas válidas quando podem ser calculadas com informações disponíveis antes da previsão. As estatísticas finais da partida não se tornam variáveis pré-jogo apenas por estarem no mesmo registro histórico.
Isso também vale para o pré-processamento. Ajuste imputação, normalização e seleção de variáveis apenas no conjunto de treino; depois aplique as transformações às partições posteriores. O guia do scikit-learn sobre vazamento de dados explica por que ajustá-las com o conjunto completo contamina a avaliação.
Separe por tempo e preserve partidas inteiras
Para avaliar o desempenho futuro, reserve um período posterior para validação e outro ainda mais recente para o teste final. Não escolha os parâmetros do modelo com base nos resultados desse teste.
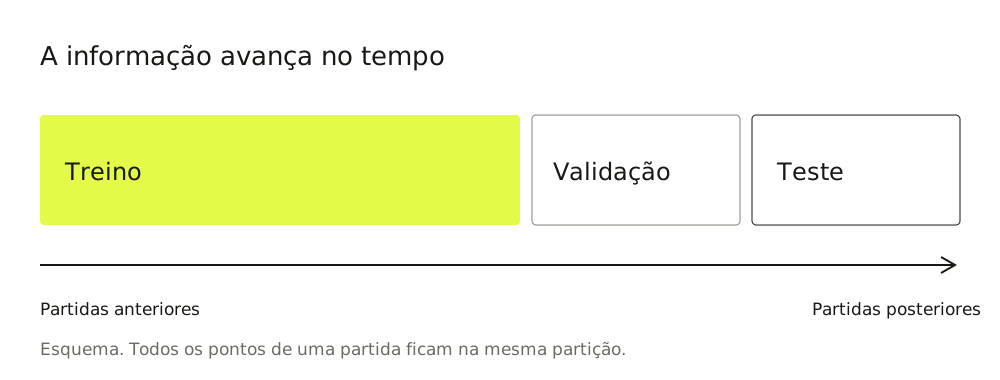
Se cada linha representa um ponto, separe primeiro a tabela de partidas e depois atribua a partição aos pontos. Distribuir pontos aleatoriamente pode colocar partes da mesma partida no treino e no teste.
Para partidas sobrepostas, use um limite conservador: os rótulos do treino devem ser conhecidos antes da primeira previsão da partição seguinte. A data de início não basta se a partida continua após o corte.
Uma pontuação melhor pode responder à pergunta errada
Antes de comparar duas medidas de acurácia, examine a separação, a amostra e as entradas disponíveis. Uma pontuação alta obtida com uma separação inadequada pode medir uma tarefa diferente da previsão de partidas futuras.
Dados ilustrativos
Mesma métrica, perguntas diferentes
% de acurácia
| Pontos aleatórios | 84 % de acurácia |
|---|---|
| Partidas cronológicas | 68 % de acurácia |
O gráfico não demonstra que a avaliação cronológica sempre reduz a acurácia. A pergunta útil é se o experimento representa as condições de uso previstas.
Torne a avaliação reproduzível
Registre o momento da previsão, os limites temporais, as regras de disponibilidade e as exclusões. A especificação abaixo é ilustrativa; não é uma chamada API nem um contrato publicado do conjunto de dados.
task: pre_match_outcome
partition_unit: match
ordering: prediction_time
training_labels_known_before: validation_start
preprocessing_fit_on: training_only
final_test_used_for_tuning: false
feature_availability: checked_at_prediction_time
| Verificação | O que registrar |
|---|---|
| Amostra | Número de partidas, período e exclusões |
| Variáveis | Definição e disponibilidade no momento da previsão |
| Referência | Um método mais simples avaliado na mesma amostra |
| Métricas | Definições, denominadores e incerteza |
| Versão | Dados, código das variáveis e configuração do modelo |
Use várias janelas temporais quando a amostra permitir. A documentação do scikit-learn descreve a avaliação ordenada no tempo. Dados de pontos de tênis também precisam ser agrupados por partida; aplicar uma divisão diretamente às linhas não substitui esse limite.
O que essa avaliação não demonstra
Uma separação cuidadosa não prova cobertura completa, entradas ao vivo confiáveis nem timestamps históricos corretos de disponibilidade. Isso exige evidências separadas. Dados corrigidos retrospectivamente podem diferir do que era observável na época.
Calibração de probabilidades e acurácia de classificação respondem a perguntas diferentes. Escolha métricas adequadas à tarefa, explique as definições e compare métodos na mesma amostra elegível.
Mantenha as evidências junto do resultado
Publique contexto suficiente para compreender o experimento. Inclua fontes, explique dados ausentes e identifique exemplos sintéticos onde aparecem. Se uma hipótese mudar, atualize o texto e a data de modificação.
Consulte nossa página de cobertura e a documentação API para os limites do produto e a integração.
Fontes
- scikit-learn: vazamento de dados e práticas recomendadas
- scikit-learn: validação cruzada de séries temporais
Fontes consultadas em 4 de outubro de 2026. A orientação de agrupar por partida aplica esses princípios; não representa um experimento medido.