Un modelo de tenis depende de cómo separas los datos en el tiempo
Una guía práctica sobre validación temporal, separación por partido y fuga de datos en modelos de tenis.
Para evaluar un modelo que hará predicciones sobre partidos futuros, entrénalo con información anterior y pruébalo con partidos posteriores. Mantén todos los puntos de un mismo partido en la misma partición. Una separación cronológica es el punto de partida; por sí sola no demuestra que cada variable estuviera disponible al predecir.
Define el momento de la predicción
Antes de elegir un modelo, define qué debe predecir y cuándo. Un modelo previo al partido y otro que se evalúa después de cada punto disponen de información diferente.
En un ejemplo previo al partido, el resultado final es la etiqueta. Las estadísticas de los jugadores solo son variables válidas si se pueden construir con información disponible antes de la predicción. Las estadísticas finales del encuentro no son variables previas al partido por el simple hecho de aparecer en el registro histórico.
Esto también se aplica al preprocesamiento: ajusta la imputación, el escalado y la selección de variables únicamente con los datos de entrenamiento. Después, aplica esas transformaciones a las particiones posteriores. La guía de scikit-learn sobre fuga de datos explica por qué ajustarlas con todo el conjunto contamina la evaluación.
Separa por tiempo y conserva los partidos completos
Para evaluar el comportamiento futuro, reserva un periodo posterior para validación y otro aún más reciente para la prueba final. No ajustes el modelo basándote en los resultados de esa prueba final.
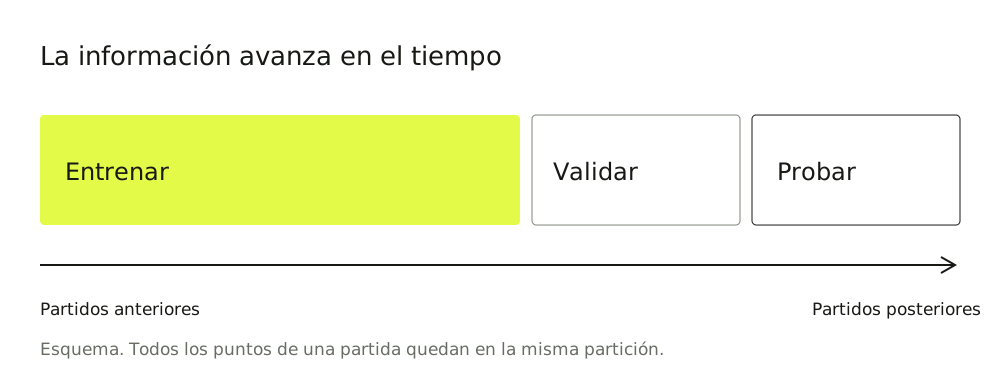
Si los registros representan puntos, separa primero la tabla de partidos y asigna después la partición a cada punto. Distribuir puntos aleatoriamente puede colocar partes del mismo partido en entrenamiento y prueba.
Si los partidos se solapan, usa un límite conservador: las etiquetas de entrenamiento deben conocerse antes de la primera predicción de la siguiente partición. La fecha de inicio no basta si el partido continúa después del corte.
Una puntuación mejor puede responder a otra pregunta
Antes de comparar dos cifras de exactitud, revisa la separación, la muestra y las variables disponibles. Una puntuación alta con una separación inadecuada puede medir una tarea distinta a predecir partidos futuros.
Datos ilustrativos
Misma métrica, distintas preguntas
% de exactitud
| Puntos aleatorios | 84 % de exactitud |
|---|---|
| Partidos cronológicos | 68 % de exactitud |
El gráfico no demuestra que la validación cronológica siempre reduzca la exactitud. La pregunta útil es si el experimento representa las condiciones de uso previstas.
Haz que la evaluación sea reproducible
Registra el momento de predicción, los límites temporales, las reglas de disponibilidad y las exclusiones. Esta especificación es ilustrativa; no es una petición API ni un contrato publicado del conjunto de datos.
task: pre_match_outcome
partition_unit: match
ordering: prediction_time
training_labels_known_before: validation_start
preprocessing_fit_on: training_only
final_test_used_for_tuning: false
feature_availability: checked_at_prediction_time
| Comprobación | Qué registrar |
|---|---|
| Muestra | Número de partidos, periodo y exclusiones |
| Variables | Definición y disponibilidad al predecir |
| Referencia | Un método más simple evaluado en la misma muestra |
| Métricas | Definiciones, denominadores e incertidumbre |
| Versión | Datos, código de variables y configuración del modelo |
Utiliza varias ventanas temporales cuando la muestra lo permita. La documentación de validación cruzada de scikit-learn describe la evaluación ordenada por tiempo. Los puntos de tenis necesitan además agruparse por partido; separar directamente las filas no sustituye ese requisito.
Qué no demuestra esta evaluación
Una separación cuidadosa no prueba una cobertura completa, entradas en directo fiables ni marcas temporales históricas correctas. Todo ello requiere evidencia adicional. Los datos corregidos retrospectivamente pueden diferir de lo observable en aquel momento.
La calibración de probabilidades y la exactitud de clasificación responden a preguntas distintas. Elige métricas acordes con la tarea, explica sus definiciones y compara los métodos en la misma muestra elegible.
Mantén la evidencia junto al resultado
Publica suficiente contexto para comprender el experimento. Enlaza las fuentes, explica los datos ausentes y señala los ejemplos sintéticos donde aparecen. Si cambia una hipótesis, actualiza el texto y su fecha de modificación.
Consulta nuestra página de cobertura y la documentación API para conocer los límites del producto y la integración.
Fuentes
- scikit-learn: fuga de datos y prácticas recomendadas
- scikit-learn: validación cruzada de series temporales
Fuentes consultadas el 4 de octubre de 2026. La agrupación específica por partido aplica estos principios; no representa un experimento medido.